Поисковая система работает не только с ключевыми словами. Ей нужно понимать, что обозначает конкретное название, человек, компания, бренд или товар и как этот объект связан с другими.
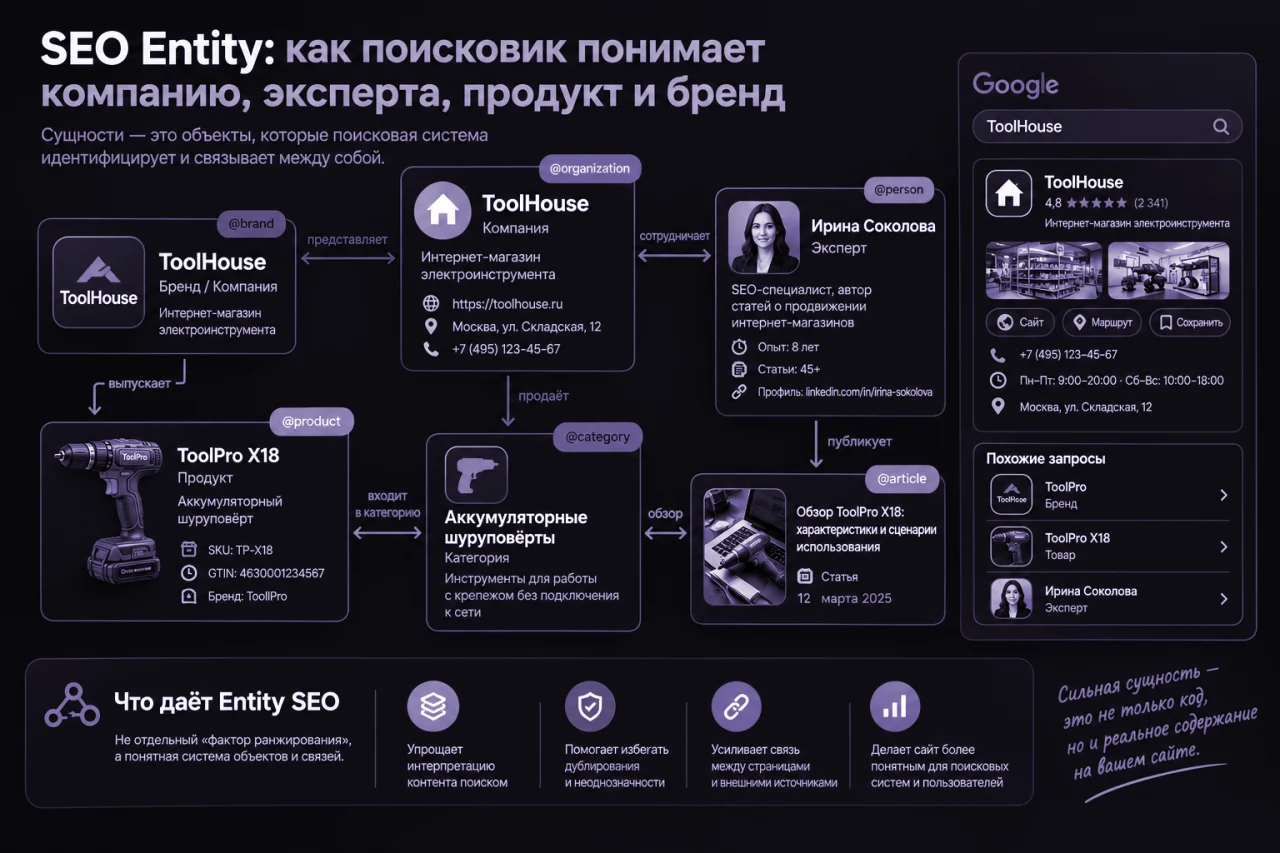
Представим интернет-магазин электроинструмента ToolHouse. В его структуре могут существовать сразу несколько разных сущностей:
ToolHouse — компания.
Ирина Соколова — автор и SEO-специалист.
ToolPro — бренд.
ToolPro X18 — конкретный товар.
Аккумуляторные шуруповёрты — категория.
Для поисковой системы важно не смешивать эти объекты и одновременно понимать связи между ними.
В Google для описания подобных объектов используется понятие entity — сущность. Knowledge Graph хранит фактические сведения о людях, организациях, местах и других объектах и связывает информацию из разных источников. Knowledge Panel, если он появляется, формируется автоматически на основе доступных данных.
В SEO для работы с такой моделью часто используют термин Entity SEO.
Что такое сущность
Сущность — это объект, который можно однозначно описать и связать с другими объектами.
Для ToolHouse структура может выглядеть так:
ToolHouse
├── представляет → ToolPro
├── продаёт → ToolPro X18
├── публикует → статьи
└── сотрудничает с → Ириной Соколовой
А товарная часть:
ToolPro
↓
ToolPro X18
↓
Аккумуляторные шуруповёрты
Это уже не набор ключевых слов, а система объектов и отношений.
Schema.org позволяет описывать такие отношения формально. В его модели используются, в частности, about, sameAs, mainEntity и mainEntityOfPage.
Entity SEO не сводится к Schema.org
Structured data — только один из элементов общей системы.
Допустим, ToolHouse добавляет на главную страницу:
{
"@type": "Organization",
"name": "ToolHouse",
"url": "https://example.com"
}
Но на самом сайте нет полноценного описания компании, в разных профилях используются разные названия, а информация о бренде противоречива.
Одна разметка не устраняет такие несоответствия.
Гораздо важнее общая согласованность:
официальный сайт → страницы компании → авторы → бренд → товары → внешние профили.
При этом structured data должна соответствовать реальному содержимому страниц, а не существовать отдельно от него. Google прямо отмечает, что структурированные данные могут помогать понимать содержание страницы, но их наличие само по себе не гарантирует специального отображения в Search.
Сначала определите, что именно вы описываете
До внедрения Schema.org нужно понять роль конкретной страницы.
В нашем примере:
ToolHouse
├── Organization
├── ToolPro
└── ToolPro X18
└── Ирина Соколова
Здесь:
ToolHouse — организация.
ToolPro — бренд.
ToolPro X18 — продукт.
Ирина Соколова — человек.
Это базовое правило Entity SEO: разные объекты должны оставаться разными объектами.
Компания как сущность
Для ToolHouse можно использовать тип Organization.
Например:
{
"@context": "https://schema.org",
"@type": "Organization",
"@id": "https://example.com/#organization",
"name": "ToolHouse",  "url": "https://example.com/",
"logo": "https://example.com/images/logo.png"
}
В зависимости от типа бизнеса можно добавить релевантные сведения: официальный адрес, телефон, юридическое название, идентификаторы и ссылки на официальные профили.
Google указывает, что Organization structured data на главной странице может помочь лучше понять административные сведения об организации и отличить её от других компаний. Некоторые свойства могут также использоваться в визуальных элементах Search.
Главное — указывать только достоверные данные.
Почему нужен @id
@id помогает ссылаться на один и тот же объект с разных страниц.
Например:
{
"@type": "Organization",
"@id": "https://example.com/#organization",
"name": "ToolHouse"
}
На странице статьи можно сослаться на этот объект:
{
"@type": "BlogPosting",
"publisher": {    "@id": "https://example.com/#organization"  }
}
Вместо создания нескольких независимых объектов получается единая идентичность ToolHouse внутри графа.
Тот же принцип можно использовать для автора и товара.
Эксперт как отдельная сущность
Ирина Соколова — не часть сущности ToolHouse. Это отдельный объект типа Person.
Например:
{
"@type": "Person",
"@id": "https://example.com/authors/irina-sokolova/#person",
"name": "Ирина Соколова",  "jobTitle": "SEO-специалист",
"url": "https://example.com/authors/irina-sokolova/"
}
Google рекомендует использовать Person для людей и Organization для организаций. Для автора также полезно указывать URL страницы, которая помогает однозначно определить человека.
Но разметка не создаёт экспертность саму по себе.
Если у Ирины нет страницы с опытом и публикациями, запись:
jobTitle: SEO-специалист не превращает её автоматически в подтверждённого эксперта.
Какая информация нужна странице автора
Страница Ирины может содержать:
- специализацию;
- профессиональный опыт;
- проекты;
- публикации;
- образование или сертификаты, если это действительно важно;
- ссылки на профессиональные профили;
- связь с ToolHouse.
Например:
Ирина Соколова
SEO-специалист
Специализация:техническое SEO, e-commerce, SEO-миграции
Опыт:8 лет
Публикации:…
Здесь реальная информация важнее объёма текста.
Как работает sameAs
sameAs используется для ссылки на внешнюю страницу, которая однозначно идентифицирует ту же сущность. Schema.org отдельно отмечает, что это могут быть, например, официальные страницы, записи в Wikidata или Wikipedia, когда они действительно относятся к тому же объекту.
Для ToolHouse:
{
"@type": "Organization",
"@id": "https://example.com/#organization",
"name": "ToolHouse",
"sameAs": [    "https://social.example.com/toolhouse"  ]
}
Для Ирины:
{
"@type": "Person",
"@id": "https://example.com/authors/irina-sokolova/#person",
"name": "Ирина Соколова",
"sameAs": [    "https://social.example.com/irina-sokolova"  ]
}
В этих примерах домены условные.
На реальном сайте нужно использовать только существующие страницы, которые действительно относятся к ToolHouse или Ирине Соколовой.
Компания и бренд — разные сущности
ToolHouse может владеть или представлять бренд ToolPro.
Связь выглядит так:
ToolHouse
└── представляет → ToolPro
└── выпускает → ToolPro X18
Сам бренд можно описать через Brand:
{
"@type": "Brand",
"@id": "https://example.com/#toolpro",
"name": "ToolPro"
}
Schema.org определяет Brand как название, которое организация или предприниматель использует для маркировки продукта, группы продуктов и других предложений.
Связываем товар с брендом
Теперь ToolPro X18 можно связать с ToolPro:
{
"@type": "Product",
"@id": "https://example.com/products/toolpro-x18/#product",
"name": "ToolPro X18",
"brand": {    "@id": "https://example.com/#toolpro"  }
}
Получается понятная цепочка:
ToolHouse → ToolPro → ToolPro X18.
При этом ToolHouse, ToolPro и ToolPro X18 остаются разными объектами.
Товар как сущность
Для карточки ToolPro X18 поисковой системе нужно получить понятные сведения:
что это за товар;
какая модель;
какой бренд;
какой идентификатор;
каковы характеристики;
есть ли цена и наличие.
Для товарных страниц Google поддерживает Product structured data. В зависимости от реализации она может использоваться для расширенных представлений информации о товарах.
Например:
{
"@type": "Product",
"@id": "https://example.com/products/toolpro-x18/#product",
"name": "ToolPro X18",
"sku": "TP-X18",
"brand": {    "@id": "https://example.com/#toolpro"  }
}
Если существуют реальные SKU, GTIN или MPN, лучше использовать именно их.
Идентификаторы нужны не ради самой разметки
Представим два товара:
ToolPro X18
ToolPro X18 Kit
Если комплектация различается, это два разных продукта.
У них должны быть разные идентификаторы и, при необходимости, отдельные URL.
Для товарных сущностей могут использоваться SKU, GTIN, MPN и другие идентификаторы. Schema.org поддерживает свойство identifier для подобных случаев.
Не следует придумывать идентификаторы только для того, чтобы заполнить JSON-LD.
Один объект — один стабильный идентификатор
Допустим, ToolHouse упоминается на двадцати страницах.
Необязательно каждый раз создавать новый объект:
{
"@type": "Organization",
"name": "ToolHouse"
}
Вместо этого можно использовать один идентификатор:
https://example.com/#organization
И ссылаться на него с разных страниц.
То же самое относится к автору:
https://example.com/authors/irina-sokolova/#person
и товару:
https://example.com/products/toolpro-x18/#product
Статья как часть entity-графа
Предположим, Ирина Соколова подготовила обзор:
ToolPro X18: характеристики и сценарии использования
Связи будут такими:
Статья
├── author → Ирина Соколова
├── publisher → ToolHouse
└── about → ToolPro X18
Например:
{
"@type": "BlogPosting",
"@id": "https://example.com/blog/toolpro-x18-review/#article",
"headline": "ToolPro X18: характеристики и сценарии использования",
"author": {    "@id": "https://example.com/authors/irina-sokolova/#person"  },
"publisher": {    "@id": "https://example.com/#organization"  },
"about": {    "@id": "https://example.com/products/toolpro-x18/#product"  }
}
Google поддерживает BlogPosting как тип Article, а для автора рекомендует указывать Person и URL страницы автора.
about, mainEntity и mainEntityOfPage
Эти свойства решают немного разные задачи.
about указывает, о какой сущности или теме идёт речь.
mainEntity обозначает основную сущность страницы.
mainEntityOfPage связывает сущность со страницей, которая её описывает.
Schema.org специально выделяет эти свойства для выражения отношений между документом и описываемыми объектами.
Например, карточка товара:
/products/toolpro-x18/
↓
mainEntity
↓
ToolPro X18
А статья-обзор:
/blog/toolpro-x18-review/
↓
Article
↓
about → ToolPro X18
Это помогает не путать сам документ с объектом, о котором он рассказывает.
Сущность должна быть видна пользователю
Один из ключевых принципов — не прятать всю информацию в JSON-LD.
Страница ToolHouse должна содержать реальные сведения о компании.
Профиль Ирины — информацию о ней.
Страница ToolPro — сведения о бренде.
Карточка ToolPro X18 — реальные характеристики товара.
То есть структура должна существовать на уровне самого сайта, а structured data только формализует её.
Внешний веб-контекст
Дополнительная информация может находиться за пределами сайта ToolHouse:
- официальные профили;
- публикации;
- интервью;
- каталоги;
- страницы партнёров;
- профессиональные профили автора.
Google указывает, что данные для Knowledge Graph поступают из разных источников, включая открытый веб и некоторые данные, предоставленные владельцами контента.
Но большое количество упоминаний не гарантирует результата.
Для поисковой системы важнее, чтобы внешние сведения действительно относились к тому же объекту и не противоречили официальным данным.
Нужно ли использовать Wikidata и Wikipedia
Нет обязательного требования создавать там страницы.
Если ToolHouse или Ирина Соколова уже представлены в Wikidata или Wikipedia и страница действительно относится к нужному объекту, её можно использовать как внешний идентификатор.
Но создавать искусственные записи только ради SEO не стоит.
Entity SEO строится прежде всего на реальных сущностях и подтверждаемой информации.
Что делать с Knowledge Panel
Knowledge Panel создаётся автоматически.
Google указывает, что такие панели формируются алгоритмически на основе информации из разных источников. Если панель относится к человеку или организации, субъект или официальный представитель может подтвердить связь с ней и предложить изменения.
Поэтому не стоит считать Schema.org механизмом «создания» Knowledge Panel.
Его задача значительно прозаичнее — помочь структурировать информацию о странице и её объекте.
Entity SEO для локального бизнеса
Предположим, у ToolHouse есть физический магазин.
Тогда структура может дополниться:
ToolHouse
├── Магазин
├── Адрес
├── Телефон
├── Часы работы
└── Услуги
Для такого сценария может использоваться подходящий подтип LocalBusiness, если он соответствует реальной модели бизнеса.
Если ToolHouse работает только онлайн, добавлять вымышленный физический адрес не нужно.
Entity SEO для интернет-магазина
В итоге граф ToolHouse может выглядеть так:
ToolHouse
├── ToolPro
└── ToolPro X18
└── Offer
├── Ирина Соколова
└── статьи
└── Каталог
└── Аккумуляторные шуруповёрты
└── ToolPro X18
Здесь каждая сущность имеет собственную роль:
ToolHouse — компания.
Ирина Соколова — автор.
ToolPro — бренд.
ToolPro X18 — продукт.
Аккумуляторные шуруповёрты — категория.
Такая модель значительно точнее, чем описание всего сайта одним объектом.
Как провести Entity-аудит
Проверку удобно разбить на несколько вопросов.
Компания
Есть ли отдельная страница ToolHouse?
Совпадает ли название с официальными источниками?
Есть ли стабильный @id?
Автор
Есть ли отдельная страница Ирины Соколовой?
Связаны ли с ней опубликованные материалы?
Используется ли Person и корректный URL автора?
Бренд
Отделён ли ToolPro от ToolHouse?
Есть ли понятная связь между ними?
Товар
Есть ли отдельная карточка ToolPro X18?
Совпадают ли модель, SKU и характеристики?
Связи
Связан ли товар с брендом?
Статья — с автором?
Статья — с товаром, если это действительно обзор этого товара?
Structured data
Соответствует ли разметка информации, которую видит пользователь?
Корректно ли используются @id, sameAs, about и mainEntity?
Внешние источники
Совпадают ли основные сведения о компании, бренде, авторе и товаре?
Типичные ошибки
Компания, бренд и товар превращаются в один объект
ToolHouse, ToolPro и ToolPro X18 должны сохранять разные роли.
Один и тот же объект получает несколько идентификаторов
Это усложняет связность графа.
Человека размечают как организацию
Для Ирины Соколовой нужен Person, а для ToolHouse — Organization.
sameAs заполняют случайными ссылками
Каждый URL должен действительно идентифицировать ту же сущность.
В разметке появляются данные, которых нет на странице
Structured data не должна содержать вымышленные характеристики или свойства.
Сущность существует только в JSON-LD
Если обычному пользователю непонятно, что представляет собой компания, автор или товар, одной разметки недостаточно.
Knowledge Panel воспринимается как гарантированный результат
Google формирует панели автоматически, и наличие structured data не гарантирует их появление.
Практическая схема внедрения
Для ToolHouse работу можно организовать так.
- Составьте список сущностей
ToolHouse
Ирина Соколова
ToolPro
ToolPro X18
Аккумуляторные шуруповёрты
- Проверьте страницы
Для каждой важной сущности должна существовать подходящая страница.
- Назначьте стабильные идентификаторы
ToolHouse→ https://example.com/#organization
Ирина Соколова→ https://example.com/authors/irina-sokolova/#person
ToolPro→ https://example.com/#toolpro
ToolPro X18→ https://example.com/products/toolpro-x18/#product
- Опишите отношения
ToolHouse → ToolPro
ToolHouse → Ирина Соколова
ToolPro → ToolPro X18
Ирина Соколова → статьи
Статья → ToolPro X18
- Добавьте structured data
Используйте типы, соответствующие реальным объектам.
- Сверьте внешние источники
Проверьте официальные профили и другие страницы, которые однозначно относятся к сущности.
- Проверьте разметку
Используйте инструменты проверки structured data и Search Console. Google рекомендует валидировать структурированные данные и отдельно контролировать возможные проблемы с ними.
Что даёт Entity SEO
Не стоит искать отдельный «entity-фактор», который автоматически повышает позиции.
Практическая ценность в другом: сайт становится понятной системой взаимосвязанных объектов.
Для ToolHouse это:
ToolHouse
↓
ToolPro
↓
ToolPro X18
и отдельно:
ToolHouse
↓
Ирина Соколова
↓
экспертные статьи
Отдельная статья может связывать оба направления:
Ирина Соколова
↓
обзор ToolPro X18
↓
ToolPro X18
↓
ToolPro
↓
ToolHouse
Система получает более ясный контекст, а сайт — более последовательную архитектуру данных.
Entity SEO — это работа не столько с ключевыми словами, сколько с идентичностью объектов и отношениями между ними.
В примере с ToolHouse:
ToolHouse — компания.
Ирина Соколова — эксперт и автор.
ToolPro — бренд.
ToolPro X18 — продукт.
Аккумуляторные шуруповёрты — категория.
У каждого объекта есть собственная роль, страница и, где это уместно, стабильный идентификатор.
Schema.org помогает описывать эти объекты и отношения, @id связывает один и тот же объект между страницами, а sameAs позволяет указывать внешние страницы, которые действительно идентифицируют ту же сущность.
При этом основа находится не в JSON-LD.
Если компания реально существует, автор действительно публикует материалы, бренд связан с реальными товарами, а информация на сайте и во внешних источниках согласована, поисковой системе проще сформировать целостное представление о проекте.
Практический смысл Entity SEO — сделать понятными не только слова на странице, но и сами объекты, которые за ними стоят, их идентичность и связи между ними.