Search Console показывает данные о поисковом трафике, индексации и сканировании. Серверные логи дают другую картину — реальные HTTP-запросы к сайту.
По ним можно определить, какой робот запросил URL, какой ответ получил сервер, какие разделы обходятся чаще всего и куда уходит основная часть crawling.
Это особенно важно для крупных сайтов, интернет-магазинов, проектов после миграции и ресурсов с большим количеством параметров, фильтров или JavaScript.
Что даёт анализ серверных логов
Основной вопрос аудита:
куда поисковые роботы тратят ресурсы на сайте?
По логам можно увидеть:
- какие поисковые роботы посещают сайт;
- какие URL они запрашивают;
- распределение обхода по разделам;
- количество 200, 3xx, 4xx, 5xx и 429;
- обращения к параметрическим и дублирующим URL;
- загрузку JavaScript, CSS и других ресурсов;
- изменения поведения роботов после миграции.
Google называет raw access logs наиболее точным источником для анализа того, какие ресурсы запрашивает Googlebot. Search Console при этом предоставляет агрегированные данные о crawling.
Как читать строку лога
Типичная запись может выглядеть так:
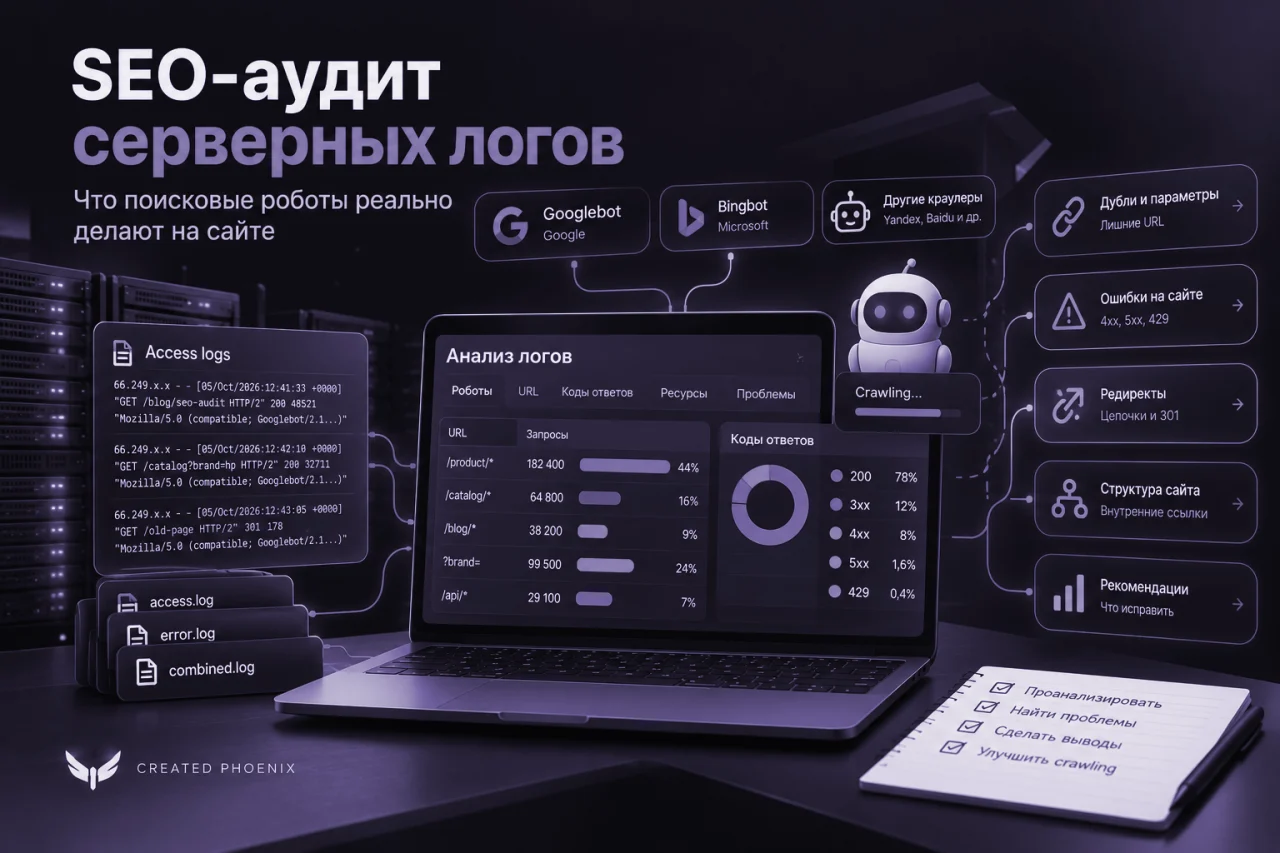
66.249.x.x - - [05/Oct/2026:12:41:33 +0000] "GET /blog/seo-audit HTTP/2" 200 48521 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"
Из неё можно получить:
- время запроса;
- URL;
- HTTP-метод;
- статус;
- размер ответа;
- User-Agent.
На большом объёме данных отдельные строки превращаются в картину поведения crawler.
Сначала классифицируйте URL
Анализировать лог построчно неэффективно. Сначала URL нужно разделить на группы:
/product/*
/catalog/*
/blog/*
?brand=
?color=
?sort=
/search?q=
/api/
После этого можно сравнить распределение запросов:
| Раздел | Запросы Googlebot | Доля |
| Товары | 182 400 | 44% |
| Категории | 64 800 | 16% |
| Блог | 38 200 | 9% |
| Фильтры | 99 500 | 24% |
| Прочие | 29 100 | 7% |
Если четверть crawling приходится на фильтры, нужно проверить, какие из них имеют самостоятельную поисковую ценность.
Google относит дубли, faceted navigation и большое количество низкоценочных URL к факторам неэффективного использования crawl budget.
Не доверяйте User-Agent без проверки
Строка:
Googlebot/2.1
не доказывает, что запрос действительно пришёл от Google.
Google рекомендует проверять такие обращения через reverse DNS и официальные IP-диапазоны.
Рабочая схема:
User-Agent → IP → проверка источника → классификация запроса.
Это особенно важно при большом бот-трафике и использовании WAF или CDN.
Какие HTTP-коды искать
200
200 OK означает, что сервер отдал ответ. Но страница при этом может быть дублем, soft 404 или содержать неправильный canonical.
3xx
Один редирект после миграции — нормальная ситуация.
Проблема возникает при цепочке:
/old-page
↓ 301
/new-page
↓ 301
/category
↓ 200
Google рекомендует избегать длинных redirect chains, поскольку они снижают эффективность crawling.
404 и 410
Сам по себе 404 не означает проблему. Но URL требует внимания, если он:
- остаётся во внутренних ссылках;
- находится в Sitemap;
- имеет внешние ссылки;
- заменён новым адресом, но не получил редирект.
5xx и 429
Массовые 500, 502, 503, 504 и регулярные 429 особенно важны.
Google указывает, что серверные ошибки и rate limiting могут снижать crawl capacity.
Показательнее всего динамика:
10:00 — 2 ошибки
11:00 — 4
12:00 — 87
13:00 — 740
14:00 — 1 120
Такой всплеск требует проверки приложения, сервера, CDN, WAF или базы данных.
Параметры и фильтры
Одна страница каталога может создавать десятки вариантов:
/catalog/notebooks
/catalog/notebooks?brand=hp
/catalog/notebooks?brand=lenovo
/catalog/notebooks?ram=16
/catalog/notebooks?ram=32
/catalog/notebooks?ram=16&brand=hp
Часть URL может быть полезна для поиска, часть — нет.
Задача аудита — определить:
какие комбинации должны существовать как самостоятельные страницы, а какие только увеличивают объём crawling.
Особенно важно анализировать URL с фильтрами, сортировкой, tracking-параметрами и внутренним поиском.
Robots.txt и noindex — не одно и то же
robots.txt регулирует crawling.
noindex используется для управления индексацией, но робот должен получить страницу, чтобы прочитать эту директиву.
Google отдельно подчёркивает это различие. Поэтому noindex не всегда является решением для сокращения ненужного crawling.
Перед изменением правил нужно определить задачу: запретить обход, убрать страницу из индекса или полностью удалить URL.
Низкая частота обхода не всегда означает проблему
Если важная страница редко запрашивается, причина может быть не в crawl budget.
Стоит проверить:
- внутренние ссылки;
- глубину страницы;
- наличие URL в Sitemap;
- частоту обновлений;
- популярность;
- технические ограничения.
Google отмечает, что crawl demand зависит от характеристик конкретных URL и сайта в целом.
При этом:
часто сканируется ≠ хорошо ранжируется.
Частота crawling сама по себе не является показателем поисковой позиции.
Что проверять после миграции
После редизайна или смены CMS сравнивайте логи до и после запуска.
В первую очередь смотрите:
- старые URL;
- новые URL;
- 301;
- 404;
- 5xx;
- параметры;
- внутренние ссылки;
- JavaScript и CSS.
Например:
/old-product → 301 → /new-product → 404
или:
/old-page → 301 → /new-page → 301 → /catalog → 200
Оба случая требуют исправления, хотя сайт внешне может работать нормально.
Логи и JavaScript
Современная страница может требовать нескольких дополнительных запросов:
/article
/assets/app.js
/assets/chunk.js
/assets/main.css
/images/article.webp
Если критически важный ресурс стабильно возвращает 403 или 404, это уже техническая проблема.
Google указывает, что raw logs позволяют увидеть обращения к CSS, JavaScript, изображениям и другим ресурсам, необходимым для обработки страницы.
Как оценивать эффективность crawling
Главное — не количество запросов, а их состав.
Предположим, Googlebot сделал 100 000 обращений.
Вариант A:
90 000 — полезные страницы
10 000 — технические URL
Вариант B:
10 000 — полезные страницы
90 000 — параметры и дубли
Объём одинаковый, а эффективность разная.
Поэтому полезно считать:
полезные URL / все URL, которые обходятся роботом.
Для важных страниц можно дополнительно отслеживать:
| URL | Обходов за 30 дней | Последний запрос | Статус |
| /services/seo | 17 | 05.10 | 200 |
| /blog/article-1 | 8 | 05.10 | 200 |
| /catalog/product-100 | 1 | 08.09 | 200 |
Редкий обход не является доказательством проблемы, но показывает URL, который стоит проверить.
Практический алгоритм аудита
Рабочий процесс можно свести к шести шагам.
- Собрать access logs
Для крупных проектов лучше анализировать несколько недель или месяц. После миграции нужны данные до и после запуска.
- Выделить поисковых роботов
Отфильтровать User-Agent и проверить подлинность Googlebot или Bingbot.
- Нормализовать URL
Отдельно обработать параметры, завершающие /, разные схемы и другие варианты одного адреса.
- Разделить URL на группы
Товары, категории, блог, фильтры, поиск, технические разделы.
- Найти аномалии
Ищите:
- всплески 5xx;
- большое количество 404;
- 429;
- длинные редиректные цепочки;
- массовые параметры;
- запросы к техническим URL;
- редкий обход важных страниц.
- Сформировать рекомендации
Каждую проблему описывайте по схеме:
проблема → причина → риск → решение → способ проверки результата.
Например:
Проблема: 28% запросов приходится на параметрические URL.
Причина: фильтры создают большое количество комбинаций.
Риск: часть crawling расходуется на страницы с низкой поисковой ценностью.
Решение: пересмотреть генерацию параметров и внутренние ссылки.
Какие инструменты использовать вместе
Серверные логи лучше не рассматривать изолированно.
Google Search Console показывает индексацию, поисковую видимость и агрегированную информацию о crawling.
Серверные логи — реальные обращения к инфраструктуре.
Краулер — структуру сайта, ссылки, canonical и метаданные.
Веб-аналитика — влияние технических изменений на трафик и конверсии.
Bing Webmaster Tools — данные Bing и дополнительные инструменты диагностики. В 2026 году Bing также добавил AI Performance для анализа цитирования страниц в AI-ответах.
Когда аудит логов оправдан
Глубокий анализ особенно полезен для:
- крупных интернет-магазинов;
- маркетплейсов;
- новостных сайтов;
- больших каталогов;
- сайтов с фильтрами;
- JavaScript-проектов;
- сайтов после миграции;
- нестабильной серверной инфраструктуры.
Для небольшого корпоративного сайта такой анализ часто избыточен. Google также отмечает, что детальная работа с crawl budget в первую очередь актуальна для крупных и технически сложных проектов.
Что должно быть в итоговом отчёте
Не нужно отдавать заказчику миллионы строк логов.
Достаточно свести ключевые данные:
| Показатель | Значение |
| Запросы Googlebot | 1 240 000 |
| Уникальные URL | 184 000 |
| 200 | 78% |
| 3xx | 12% |
| 4xx | 8% |
| 5xx | 1,6% |
| 429 | 0,4% |
| Параметрические URL | 28% |
Далее — несколько приоритетных проблем с конкретными действиями.
Серверный лог показывает фактическое поведение поисковых роботов: какие URL они запрашивают, какие ответы получают и куда уходит основная часть crawling.
Наиболее важные задачи анализа:
- найти лишние параметры и дубли;
- обнаружить серверные ошибки;
- проверить редиректы после миграции;
- выявить проблемы с WAF и rate limiting;
- убедиться, что важные страницы доступны и связаны с сайтом;
- сравнить поведение роботов до и после изменений.
При этом цель не в увеличении количества визитов Googlebot.
Цель — сделать crawling эффективным: поисковый робот должен получать доступ прежде всего к тем страницам, которые имеют поисковую и бизнес-ценность.
Именно поэтому серверные логи особенно полезны в техническом SEO-аудите крупных и сложных сайтов: они позволяют увидеть реальное взаимодействие поискового робота с инфраструктурой, а не только итоговые показатели в интерфейсе поисковой системы.