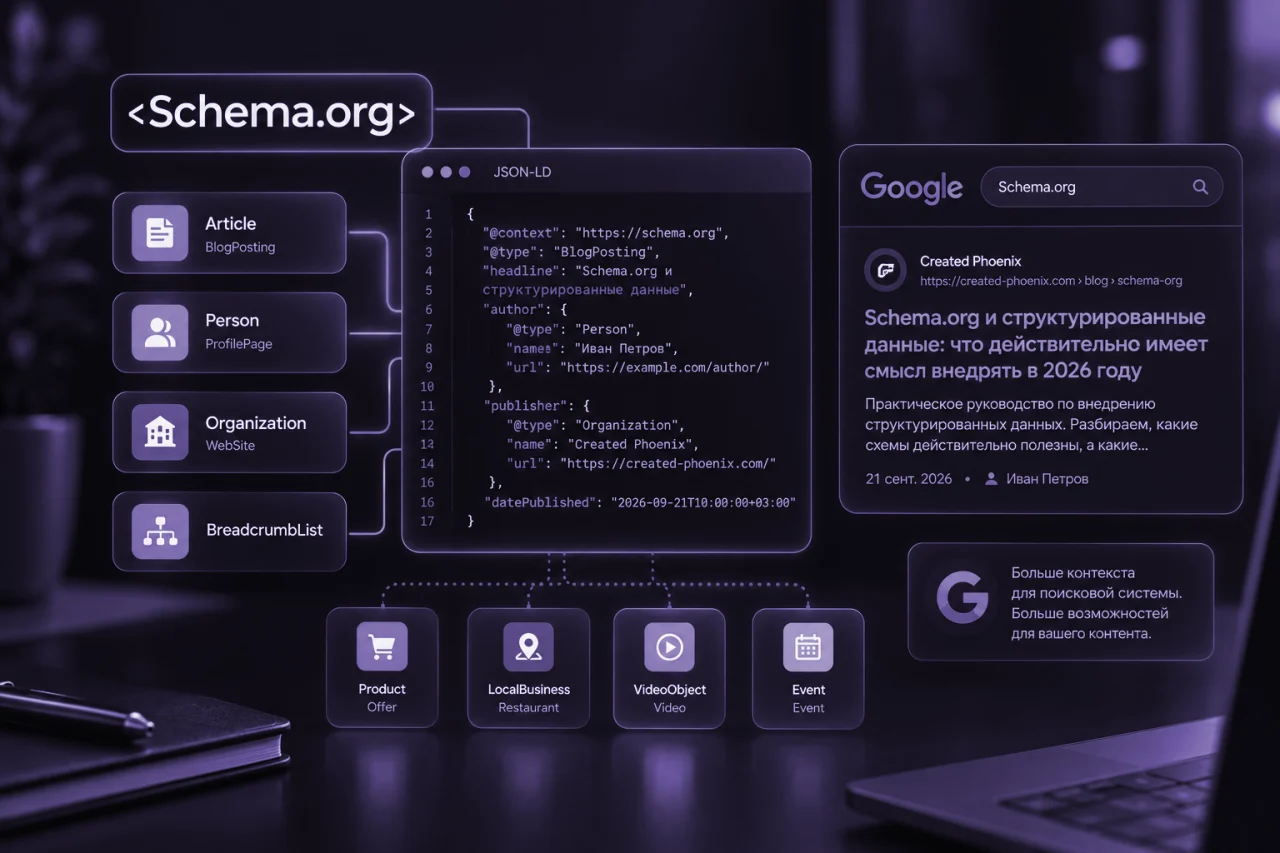
Структурированные данные часто воспринимают как ещё один технический пункт SEO-чек-листа: добавить JSON-LD, проверить через валидатор и перейти к следующей задаче.
Такой подход слишком упрощает задачу.
Schema.org не поднимает страницу в поиске сам по себе и не превращает обычный текст в экспертный материал. Его задача гораздо прозаичнее и одновременно полезнее: дать поисковой системе дополнительный контекст о содержимом страницы.
На сайте есть статья, товар, организация, автор, событие или видео. Для человека это очевидно из интерфейса и текста. Для поисковой системы приходится собирать эти сведения из множества сигналов. Структурированная разметка позволяет описать их более явно.
Google использует structured data для понимания содержимого страницы и может учитывать её при формировании некоторых расширенных представлений в результатах поиска. При этом корректная разметка не гарантирует появление rich result.
Поэтому хороший вопрос звучит не так:
«Какую Schema-разметку добавить, чтобы получить больше трафика?»
Гораздо полезнее спросить:
«Какие сущности существуют на странице и какие из них поисковой системе имеет смысл описать явно?»
Именно с этой точки зрения и стоит подходить к Schema.org.
Что такое Schema.org
Schema.org — это словарь типов и свойств, предназначенный для машиночитаемого описания информации на веб-страницах.
Например, обычный HTML может содержать:
<h1>Иван Петров</h1>
Посетителю понятно, что это имя человека. Но отдельно от контекста сам HTML не сообщает поисковой системе, что перед ней именно Person.
Schema.org позволяет обозначить это явно:
{
"@context": "https://schema.org",
"@type": "Person",
"name": "Иван Петров"
}
Точно таким же способом можно описывать организации, статьи, товары, события, видео и другие сущности.
Schema.org поддерживает различные форматы представления структурированных данных, включая JSON-LD, Microdata и RDFa. На практике для современных сайтов JSON-LD обычно удобнее всего поддерживать отдельно от основной HTML-структуры.
Здесь есть важное различие.
Schema.org — это словарь.
Google Search — конкретный потребитель части этих данных.
Наличие типа в Schema.org не означает, что Google обязательно создаст для него отдельный элемент поисковой выдачи.
Structured data не является «секретным фактором ранжирования»
Это один из самых живучих мифов вокруг микроразметки.
Добавление Article, Product или Organization не означает автоматического улучшения позиции страницы.
Google использует структурированные данные, чтобы лучше понимать содержание документа и в определённых случаях предоставить странице право на расширенное отображение. Но даже при идеально валидной разметке Google не обязан показывать соответствующий rich result.
Поэтому оценивать внедрение Schema стоит сразу по нескольким критериям:
- поисковой системе проще классифицировать страницу;
- сущности сайта становятся однозначнее;
- данные для rich result передаются в стандартизированном виде;
- уменьшается неоднозначность между разными элементами страницы;
- появляется единая семантическая модель сайта.
Если единственная цель внедрения — «поднять позиции», ожидания, скорее всего, будут завышенными.
Какие схемы нужны контентному сайту
Для экспертного блога обычно нет необходимости использовать десятки типов Schema.org.
Намного полезнее построить небольшое, но связное ядро.
Для большинства контентных проектов я бы начал с:
- Article или BlogPosting;
- Person для автора;
- ProfilePage для страницы автора;
- Organization;
- WebSite;
- BreadcrumbList.
На отдельных шаблонах могут добавляться Product, Event, VideoObject, LocalBusiness и другие сущности.
Главный принцип здесь простой:
тип Schema должен соответствовать реальной сущности страницы.
Не наоборот.
BlogPosting: базовый слой для статей
Для публикаций блога Google поддерживает Article и его специализированный вариант BlogPosting.
Такая разметка позволяет передавать дополнительный контекст:
- заголовок статьи;
- изображения;
- дату публикации;
- дату изменения;
- автора;
- информацию о странице, к которой относится материал.
Google прямо указывает, что Article structured data помогает лучше понимать статьи и может использоваться для формирования более информативных вариантов представления в Search.
Пример:
{
"@context": "https://schema.org",
"@type": "BlogPosting",
"@id": "https://example.com/blog/schema-org/#article",
"headline": "Schema.org и структурированные данные",
"description": "Практическое руководство по внедрению структурированных данных.",
"image": ["https://example.com/images/schema-org.jpg"],
"datePublished": "2026-09-21T10:00:00+03:00",
"dateModified": "2026-09-21T15:30:00+03:00",
"author": {
"@type": "Person",
"@id": "https://example.com/author/expert/#person",
"name": "Имя Фамилия",
"url": "https://example.com/author/expert/"
},
"publisher": {
"@id": "https://example.com/#organization"
},
"mainEntityOfPage": {
"@id": "https://example.com/blog/schema-org/"
}
}
Сама конструкция несложная. Гораздо важнее то, насколько честно она заполнена.
Если статья опубликована 21 сентября, не стоит указывать другую дату только потому, что она лучше выглядит для поисковой выдачи.
Если у материала один автор, не нужно добавлять несколько Person ради более «богатой» схемы.
Google отдельно рекомендует корректно указывать всех авторов страницы, использовать type и ссылку на профиль автора через url или sameAs, когда это возможно.
Авторская разметка важнее количества JSON-LD
Для экспертного блога автор — не декоративный элемент.
Пользователь должен понимать:
кто написал материал;
какая у этого человека специализация;
где посмотреть информацию об авторе.
Google рекомендует понятные byline и страницы авторов там, где авторство ожидаемо. В руководстве по people-first content это непосредственно связано с тем, насколько легко посетителю понять происхождение и экспертность контента.
Отсюда возникает связка:
Article
↓
Person
↓
ProfilePage
Например:
{
"@type": "ProfilePage",
"@id": "https://example.com/author/expert/",
"mainEntity": {
"@type": "Person",
"@id": "https://example.com/author/expert/#person",
"name": "Имя Фамилия",
"url": "https://example.com/author/expert/"
}
}
Но здесь особенно легко перейти грань между оптимизацией и фикцией.
Не стоит добавлять человеку несуществующие сертификаты, должности, десятилетия опыта или регалии только для того, чтобы профиль выглядел убедительнее.
Schema.org описывает человека. Она не создаёт его экспертизу.
E-E-A-T начинается не с Schema.org
E-E-A-T часто пытаются свести к набору технических параметров. На практике это работает наоборот.
Сначала появляется реальный автор и качественный материал. Затем уже имеет смысл технически описать эту структуру.
Google относит Experience, Expertise, Authoritativeness и Trust к концепции E-E-A-T, отдельно подчёркивая, что E-E-A-T не является самостоятельным единичным ranking factor. При этом Google рекомендует обращать внимание на понятное авторство, оригинальность, качество исследования и наличие реальной ценности для читателя.
Для экспертной статьи полезна последовательность:
Реальный автор
↓
Практический опыт
↓
Оригинальный анализ
↓
Источники и доказательства
↓
Редактура и фактчекинг
↓
Понятная страница автора
↓
Structured data
А не наоборот:
JSON-LD
↓
E-E-A-T
↓
Экспертность
Последняя схема просто не работает.
Organization: кто стоит за сайтом
Если сайт принадлежит компании или профессиональному проекту, имеет смысл описать организацию через Organization либо подходящий специализированный тип.
Google позволяет указывать соответствующие сведения об организации, включая название, URL, логотип и другие применимые свойства. Для Organization нет требования заполнять огромный фиксированный набор полей — Google рекомендует добавлять те свойства, которые действительно относятся к конкретной странице и организации.
Базовая конструкция может выглядеть так:
{
"@type": "Organization",
"@id": "https://example.com/#organization",
"name": "Example Company",
"url": "https://example.com/",
"logo": {
"@type": "ImageObject",
"url": "https://example.com/logo.png"
}
}
Дальше эту организацию можно связать с публикациями через @id.
Это лучше, чем многократно создавать практически одинаковые объекты Organization на разных страницах.
WebSite и название сайта
WebSite применяется для описания самого сайта как отдельной сущности.
Один из практических сценариев — указать название сайта, которое Google может использовать как один из источников при формировании site name. Google рассматривает structured data наряду с другими сигналами со страницы и сайта, поэтому одна только разметка не гарантирует конкретное отображение названия.
Пример:
{
"@type": "WebSite",
"@id": "https://example.com/#website",
"url": "https://example.com/",
"name": "Example"
}
Для брендов с несколькими вариантами названия это особенно полезно как часть общей семантической структуры сайта.
BreadcrumbList: небольшая схема с понятной задачей
Хлебные крошки выполняют сразу две функции. Для пользователя они показывают место страницы в структуре сайта.
Для поисковой системы дают дополнительный контекст относительно иерархии.
Google поддерживает BreadcrumbList как отдельный тип structured data и рекомендует описывать реальную логическую цепочку навигации.
Например:
Главная
→ Блог
→ Раздел
→ Статья
Здесь не стоит пытаться повторить URL буквально.
URL может быть:
/blog/schema-org-structured-data/
а логическая структура сайта:
Блог → Раздел → Подраздел → Статья
Для поисковой системы важнее смысловая иерархия, а не механическое копирование адреса страницы.
Product: там, где Schema действительно особенно полезна
Для интернет-магазина structured data имеет гораздо более практическое значение.
Product и связанные с ним данные используются Google для различных поисковых представлений товара. В зависимости от типа страницы могут передаваться цена, наличие, отзывы и другие сведения. Для merchant listings доступны дополнительные данные, включая информацию о доставке и возврате.
Здесь есть важное ограничение.
Страница должна действительно быть страницей товара.
Не стоит ставить Product на каталог только потому, что там перечислены десять товаров.
Google отдельно указывает, что product rich results ориентированы на страницы, посвящённые конкретному товару или его вариантам, а не на обычные категории товаров.
Типичная структура:
{
"@type": "Product"
"name": "Название товара",
"image": ["https://example.com/product.jpg"],
"description": "Описание товара",
"sku": "ABC-123",
"brand": {
"@type": "Brand",
"name": "Brand"
},
"offers": {
"@type": "Offer",
"price": "199.00",
"priceCurrency": "EUR",
"availability": "https://schema.org/InStock"
}
}
Самое важное здесь — синхронность.
Если на странице цена €199, а в structured data стоит €149, проблема не в формате JSON-LD. Проблема в качестве данных.
Динамический Product JSON-LD требует осторожности
Современные магазины часто формируют structured data через JavaScript.
Технически это возможно. Но для товаров с быстро меняющимися ценами и остатками есть дополнительный риск: Google предупреждает, что динамически создаваемая product-разметка может приводить к менее частому или менее надёжному обновлению Shopping-данных. Для merchant-сценариев Google рекомендует по возможности размещать Product structured data в исходном HTML.
Поэтому для магазина схема:
сервер
↓
HTML
↓
Product JSON-LD
часто практичнее, чем:
HTML
↓
JavaScript
↓
API
↓
Product JSON-LD
особенно если стоимость и наличие меняются несколько раз в день.
LocalBusiness для локальных компаний
Для компании с физическим местоположением используется LocalBusiness или более конкретный подтип.
Например:
- Restaurant;
- специализированный тип организации;
- другой подходящий подтип локального бизнеса.
Google рекомендует по возможности использовать наиболее конкретный тип, который действительно соответствует бизнесу.
Здесь опять работает тот же принцип: разметка должна описывать реальный объект.
Если у компании нет офиса для посещения, не нужно создавать фиктивную локальную точку только ради дополнительных структурированных данных.
VideoObject: только там, где есть реальное видео
VideoObject полезен для страниц, на которых действительно размещён видеоматериал.
В structured data можно описать, например:
- название;
- описание;
- thumbnail;
- продолжительность;
- дату публикации;
- другие параметры видео.
Google использует такую информацию в соответствующих поисковых сценариях для видео. Само присутствие JSON-LD, конечно, не означает гарантированного появления видео в выдаче.
Практическая ценность этой схемы появляется именно тогда, когда видео — часть основного контента страницы, а не искусственно добавленный объект.
Event: только для настоящих мероприятий
Event имеет смысл для страниц реальных мероприятий:
- конференций;
- вебинаров;
- выставок;
- концертов;
- семинаров;
- других событий с конкретными параметрами.
Создавать Event для обычной рекламной акции или блока «спецпредложение до конца месяца» не стоит, если по смыслу это не мероприятие.
Schema.org не должна подменять собой содержание страницы.
Что делать с FAQ-разметкой в 2026 году
Здесь ситуация изменилась принципиально. В мае 2026 года Google прекратил показывать FAQ rich results в поиске. В июне 2026 года Google также удалил соответствующую документацию из Search Central. Поэтому старые рекомендации «добавить FAQPage на все коммерческие страницы ради расширенного сниппета» сегодня неактуальны.
Сам FAQ-блок при этом никуда не исчез.
Хороший раздел вопросов и ответов по-прежнему полезен для посетителя, помогает закрыть сомнения и делает страницу удобнее.
Но мотив должен быть другим:
FAQ создаётся для пользователя, а не ради давно исчезнувшего rich result.
Это хороший пример того, почему нельзя годами механически копировать старые SEO-чек-листы.
Не всё из Schema.org нужно размечать
Это ещё одна распространённая крайность. В документации Schema.org существует огромное количество типов и свойств. Но сайт практически никогда не должен пытаться внедрить «максимально возможное количество схем».
Представим обычную статью.
На ней действительно могут существовать:
- организация;
- автор;
- веб-сайт;
- статья;
- изображение;
- навигационная цепочка.
Этого может быть достаточно.
Нет смысла добавлять:
- Event, если никакого события нет;
- Product, если статья ничего не продаёт;
- Review, если это не обзор;
- VideoObject, если видео отсутствует;
- другие сущности только ради увеличения объёма JSON-LD.
Лишняя разметка не делает сайт более экспертным.
В лучшем случае она бесполезна. В худшем — создаёт противоречивые или недостоверные данные.
Единый граф сущностей лучше набора разрозненных блоков
На крупном сайте особенно важно не просто добавить несколько JSON-LD-блоков, а связать их между собой.
Например:
Organization
│
├── WebSite
│
└── Person
│
└── BlogPosting
│
└── WebPage
Связи можно задавать через стабильные @id.
Пример:
{
"@context": "https://schema.org",
"@graph": [
{
"@type": "Organization",
"@id": "https://example.com/#organization",
"name": "Example Company",
"url": "https://example.com/"
},
{
"@type": "WebSite",
"@id": "https://example.com/#website",
"url": "https://example.com/",
"name": "Example"
},
{
"@type": "Person",
"@id": "https://example.com/author/expert/#person",
"name": "Имя Фамилия",
"url": "https://example.com/author/expert/"
},
{
"@type": "BlogPosting",
"@id": "https://example.com/blog/article/#article",
"headline": "Название статьи",
"author": {
"@id": "https://example.com/author/expert/#person"
},
"publisher": {
"@id": "https://example.com/#organization"
},
"mainEntityOfPage": {
"@id": "https://example.com/blog/article/"
}
}
]
}
Преимущество такого подхода не в том, что JSON выглядит сложнее.
Наоборот: логика становится понятнее.
У сайта есть конкретная организация. У неё есть сайт. У статьи есть автор. Статья относится к конкретной странице. Каждая сущность имеет устойчивый идентификатор.
Получается не набор несвязанных описаний, а одна модель.
JSON-LD или Microdata?
Оба подхода поддерживаются экосистемой Schema.org.
На практике для современных проектов JSON-LD часто оказывается удобнее:
- его проще генерировать автоматически;
- его легче поддерживать на уровне шаблонов;
- он меньше смешивается с HTML;
- его проще централизованно изменять;
- он хорошо подходит для CMS и масштабных проектов.
Schema.org поддерживает JSON-LD, Microdata и RDFa как способы передачи своих типов и свойств.
При этом формат не должен становиться целью сам по себе. Главное — содержание данных.
AI-контент и структурированные данные
Вокруг AI-контента тоже возникло немало мифов. Использование генеративных инструментов само по себе не является проблемой. Google прямо говорит, что автоматизация, включая AI, может применяться при создании полезного контента. Проблемой становится использование автоматизации прежде всего для манипуляции поисковой выдачей.
В более свежих рекомендациях Google для AI Search акцент сделан на уникальности материала, собственном опыте, оригинальном анализе и ценности для аудитории. Простое переписывание того, что уже опубликовано десятками сайтов, не превращается в сильный материал только потому, что текст структурирован и размечен Schema.org.
Поэтому для экспертного блога рабочий процесс выглядит примерно так:
Вопрос аудитории
↓
Исследование
↓
Собственный анализ
↓
Практические примеры
↓
Редактура
↓
Проверка фактов
↓
Публикация
↓
Structured Data
А не:
Ключевое слово
↓
AI-генерация
↓
Schema.org
↓
Публикация
Последний вариант легко масштабируется, но плохо масштабирует доверие.
Как вписать Schema.org в E-E-A-T
Если задача — сделать экспертный блог убедительнее для пользователей и поисковых систем, structured data лучше рассматривать как часть более крупной системы.
На уровне страницы:
Автор
Есть имя автора, фотография или профиль, специализация и ссылка на подробную страницу.
Содержание
Есть оригинальная информация, а не компиляция из нескольких чужих статей.
Источники
Фактические утверждения можно проверить.
Актуальность
Для меняющихся тем указаны дата публикации и дата обновления, когда это действительно необходимо.
Редакционная прозрачность
Понятно, кто подготовил материал и как он появился.
Структурированные данные
Эта информация дополнительно описана в машиночитаемом формате.
Google отдельно предлагает оценивать контент через вопросы «Who, How, Why»: кто создал материал, как он создавался и зачем он вообще был опубликован. При этом Google не рекомендует создавать контент исключительно ради поискового трафика.
Как проверять микроразметку после внедрения
Публикация JSON-LD — не финальная точка.
Минимальный контроль состоит из нескольких этапов.
-
Проверить синтаксис и поддерживаемые возможности
Для Google используется Rich Results Test.
Важно понимать, что валидатор проверяет техническую сторону конкретных поисковых возможностей, а не определяет качество всей семантической архитектуры сайта.
-
Проверить страницу в Search Console
Google рекомендует использовать URL Inspection, чтобы увидеть, как поисковая система получает доступ к странице и данным.
-
Проверить соответствие HTML и JSON-LD
Это особенно важно для:
- цен;
- рейтингов;
- наличия;
- дат;
- авторов;
- названий;
- изображений.
Самая частая логическая ошибка выглядит примерно так:
На странице:
Цена €199
В Schema:
Цена €149
Формально JSON может быть идеально написан. С точки зрения данных он всё равно неправильный.
-
Следить за Search Console после изменений шаблонов
При изменении CMS, шаблона или логики генерации structured data важно смотреть, не выросло ли количество invalid items.
Google рекомендует мониторить structured data после внедрения и после существенных изменений шаблонов.
Что внедрять на разных типах страниц
| Тип страницы | Базовый набор |
| Главная корпоративного сайта | Organization, WebSite |
| Статья блога | Article / BlogPosting, автор |
| Страница автора | ProfilePage, Person |
| Материал с хлебными крошками | BreadcrumbList |
| Карточка товара | Product, Offer |
| Локальный бизнес | LocalBusiness или более конкретный тип |
| Страница с видео | VideoObject |
| Страница мероприятия | Event |
Это не универсальный шаблон для каждого сайта. Набор должен зависеть от фактического содержания страницы и от того, какие поисковые возможности поддерживает Google для конкретного типа данных.
Какие ошибки встречаются чаще всего
Разметка того, чего нет на странице
Например, Review без настоящего отзыва или VideoObject без видео.
Несовпадение данных
Цена, дата, название или автор различаются между видимым контентом и JSON-LD.
Фиктивная экспертность
В Schema добавляются придуманные должности, сертификаты, достижения и прочие атрибуты.
Дублирование сущностей
На каждой странице создаётся отдельный Organization без единого @id.
Использование старых SEO-рецептов
Особенно это касается FAQ. Поисковая экосистема меняется, поэтому список «обязательной микроразметки» из статьи трёхлетней давности сегодня может быть просто неактуален.
Оптимизация JSON-LD вместо страницы
Самая фундаментальная ошибка.
Если страница плохо отвечает на запрос пользователя, идеальная Schema.org-структура не исправит проблему.
Главное — не переоценивать саму микроразметку
Schema.org хороша там, где решает конкретную задачу. Она помогает описать содержание, связать сущности и дать поисковой системе дополнительные структурированные сигналы.
Но она не заменяет:
- техническую доступность сайта;
- правильную индексацию;
- архитектуру URL;
- внутреннюю перелинковку;
- качественный текст;
- авторство;
- оригинальные исследования;
- реальные отзывы;
- хороший пользовательский опыт.
Google в своих рекомендациях делает акцент именно на полезном, надёжном и people-first контенте. Для AI Search компания отдельно подчёркивает значение уникального материала, оригинального опыта и информации, которая действительно добавляет что-то сверх уже существующего контента.
В 2026 году Schema.org разумнее воспринимать не как набор SEO-трюков, а как семантический слой сайта.
Для контентного проекта основой обычно становятся:
Article / BlogPosting → Person / ProfilePage → Organization → WebSite → BreadcrumbList.
Для интернет-магазина к ним добавляется:
Product → Offer и связанные товарные данные.
Для локального бизнеса — LocalBusiness.
Для видеоконтента — VideoObject.
Для событий — Event.
А устаревшие рецепты вроде массового внедрения FAQ Schema ради rich snippets уже не имеют прежнего смысла: Google прекратил показывать FAQ rich results в поиске в 2026 году.
Важнее всего другое.
Сначала должна существовать реальная сущность. Потом — корректное описание этой сущности. И только после этого — Schema.org.
Если на странице действительно есть эксперт, его профиль должен быть понятен пользователю. Если есть компания — её данные должны быть достоверными. Если есть товар — цена и наличие должны совпадать с реальностью. Если есть статья — автор, дата и содержание должны соответствовать опубликованному материалу.
Так структурированные данные становятся не отдельным SEO-ритуалом, а частью нормальной информационной архитектуры.
Именно такой подход лучше всего соответствует современной философии Google: создавать оригинальный, полезный и проверяемый контент для людей, а технические сигналы использовать для того, чтобы этот контент было проще правильно понять.