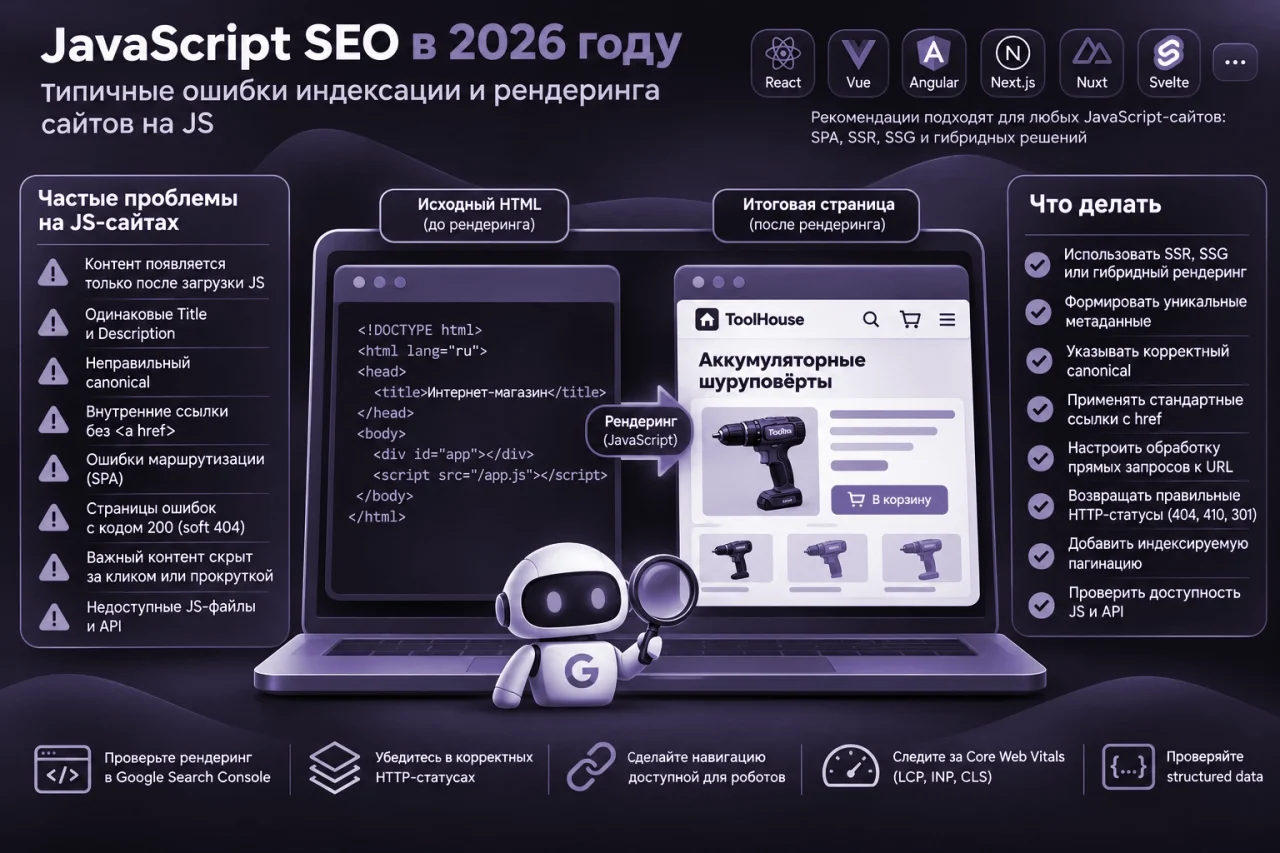
Современный сайт может выглядеть безупречно в браузере и одновременно испытывать проблемы с поисковой индексацией. Пользователь видит каталог, описание товара и работающую навигацию, а поисковый робот получает почти пустой HTML, не обнаруживает часть ссылок или сталкивается с ошибками загрузки данных.
Такие ситуации встречаются на проектах, использующих React, Vue, Angular, Svelte, Next.js, Nuxt и другие JavaScript-технологии. Причина обычно связана не с выбранным фреймворком, а со способом формирования страниц и организацией взаимодействия между сервером и браузером.
Google умеет выполнять JavaScript с помощью современной версии Chromium. Однако рендеринг требует дополнительных ресурсов, а возможности других поисковых роботов могут отличаться. Поэтому при разработке важно учитывать не только то, как сайт работает для пользователя, но и какое содержимое доступно поисковой системе.
Как поисковые системы обрабатывают JavaScript-сайты
Обработка страницы включает несколько этапов: получение HTML, выполнение JavaScript при необходимости и анализ итогового содержимого.
Для обычного HTML-сайта значительная часть информации доступна сразу после ответа сервера.
В JavaScript-приложении первоначальный документ может выглядеть так:
<!DOCTYPE html>
<html lang="ru">
<head>
<title>Каталог электроинструмента</title>
</head>
<body>
<div id="app"></div>
<script src="/assets/app.js"></script>
</body>
</html>
Каталог, заголовки и карточки товаров появляются только после выполнения скрипта.
Google способен обработать подобную страницу, но результат зависит от успешной загрузки ресурсов, работы приложения и доступности данных. Если ключевой JavaScript-файл возвращает ошибку или API недоступен, поисковая система может получить неполное содержимое.
Поэтому для публичных страниц с важным поисковым трафиком предпочтительна архитектура, при которой основной контент доступен уже в первоначальном HTML. Это не обязательное условие индексации, а способ уменьшить зависимость от клиентского рендеринга.
CSR, SSR и SSG: что выбрать для SEO
JavaScript-сайт необязательно должен целиком использовать один способ формирования страниц.
| Подход | Как работает | Особенности |
| CSR | Контент формируется в браузере | Зависит от выполнения JavaScript |
| SSR | HTML создаётся сервером при запросе | Основное содержимое доступно сразу |
| SSG | HTML генерируется заранее | Подходит для страниц с относительно стабильным контентом |
| Гибридный | Сочетает разные методы | Позволяет выбирать подход для отдельных разделов |
Клиентский рендеринг — CSR
Client-Side Rendering часто используется в SPA-приложениях. Сервер отдаёт базовую HTML-оболочку, а браузер загружает необходимые данные и формирует интерфейс.
Для личного кабинета, CRM или другого закрытого приложения такой подход обычно оправдан.
Для публичного интернет-магазина или информационного портала CSR требует дополнительного внимания к индексации, навигации и метаданным.
Серверный рендеринг — SSR
При Server-Side Rendering сервер сразу формирует HTML с основным содержимым страницы.
Например, робот получает не пустой контейнер приложения, а готовую категорию с H1, описанием, товарами и ссылками.
JavaScript затем может подключать интерактивность: фильтры, поиск, корзину и другие элементы.
Статическая генерация — SSG
Static Site Generation создаёт HTML заранее, обычно на этапе сборки проекта.
Этот подход удобен для статей, документации, справочных разделов и страниц, содержимое которых не меняется при каждом запросе.
Для крупных проектов часто применяется сочетание SSR, SSG и CSR. Например, страницы каталога формируются на сервере, статьи генерируются заранее, а личный кабинет работает как клиентское приложение.
Для SEO важен не сам метод рендеринга, а доступность содержимого, корректная обработка URL и стабильная работа страниц.
Ошибка №1. Основной контент появляется только после загрузки JavaScript
Представим карточку товара, на которой посетитель видит название, характеристики, фотографии и стоимость.
Однако первоначальный HTML содержит только:
<div id="root"></div>
Все данные загружаются через API после запуска приложения.
Такая страница может индексироваться, но становится зависимой от выполнения клиентского кода.
Как обнаружить проблему
Сравните два состояния страницы:
Исходный HTML — документ, который непосредственно возвращает сервер.
Итоговый DOM — содержимое после выполнения JavaScript.
Первый вариант можно получить через просмотр исходного кода или HTTP-запрос. Второй — через инструменты разработчика браузера.
Если основной контент существует только в итоговом DOM, проверьте страницу через Google Search Console.
Особое внимание уделите тому, отображаются ли в обработанной версии H1, основной текст, товары и внутренние ссылки.
Как исправить
Для важных коммерческих и информационных страниц можно использовать SSR или SSG. Если проект остаётся на CSR, необходимо обеспечить стабильное выполнение скриптов, доступность API и корректный результат рендеринга.
Полностью отказываться от JavaScript не требуется.
Ошибка №2. Метаданные формируются неправильно
На JavaScript-сайтах нередко используют один шаблон HTML для всех маршрутов.
В результате категория, карточка товара и статья получают одинаковые метаданные:
<title>Интернет-магазин</title>
<meta name="description" content="Каталог товаров">
Это затрудняет определение назначения отдельных страниц.
Для каждой индексируемой страницы желательно формировать собственный Title и Description, соответствующие её содержимому.
Например:
<title>Аккумуляторные шуруповёрты — каталог моделей</title>
<meta name="description" content="Аккумуляторные шуруповёрты: характеристики, комплектации и сравнение моделей." >
Google способен обрабатывать метаданные, добавленные через JavaScript. Тем не менее для SSR- и SSG-проектов удобнее формировать их вместе с основным HTML.
Особое внимание — canonical
Проблемы возникают, когда сервер возвращает один canonical, а JavaScript заменяет его другим.
Например, первоначальный HTML указывает на главную страницу:
<link rel="canonical" href="https://example.com/">
После рендеринга адрес меняется на:
<link rel="canonical" href="https://example.com/catalog/drills/">
Такая реализация может создавать противоречивые сигналы.
Предпочтительно указывать правильный canonical сразу в HTML. Если он формируется через JavaScript, не следует оставлять в исходном документе другое значение.
Также необходимо исключить появление нескольких конфликтующих canonical.
Ошибка №3. В исходном HTML присутствует noindex
Иногда разработчики добавляют:
<meta name="robots" content="noindex">
а после загрузки данных удаляют эту директиву с помощью JavaScript.
Для индексируемых страниц такой подход рискован.
Обнаружив noindex, Google может не выполнять дальнейший рендеринг. Следовательно, JavaScript, который должен удалить запрет, может вообще не запуститься в процессе поисковой обработки.
Если страница предназначена для индексации, её первоначальный HTML не должен содержать временный noindex.
Для действительно закрытых разделов директивы необходимо задавать в соответствии с назначением страницы.
Ошибка №4. Внутренние ссылки работают только через JavaScript
Сайты на JavaScript часто используют собственные компоненты навигации.
Например:
<div onclick="openCategory('drills')">Дрели</div>
Пользователь может нажать на такой элемент и перейти в категорию. Но для поискового робота он не является обычной HTML-ссылкой.
Надёжнее использовать:
<a href="/catalog/drills/">Дрели</a>
JavaScript по-прежнему может перехватывать переход и выполнять клиентскую навигацию.
Важно, чтобы ссылка сохраняла корректный href.
Это касается меню, карточек товаров, хлебных крошек, статей и пагинации.
Особенно внимательно стоит проверять страницы, доступные только после взаимодействия с интерфейсом. Если на URL невозможно попасть через обычную ссылку, его обнаружение поисковой системой может осложниться.
Ошибка №5. SPA некорректно обрабатывает прямые обращения к URL
В одностраничном приложении переход между разделами часто происходит без полной перезагрузки страницы.
Например:
/catalog/
/catalog/drills/
/catalog/drills/model-x/
Внутри приложения всё работает, но при прямом открытии карточки товара сервер возвращает 404.
Причина заключается в том, что маршрут настроен в клиентском приложении, но не обрабатывается сервером.
Правильная реализация
Каждый публичный URL должен корректно открываться при прямом HTTP-запросе.
Однако просто возвращать 200 для любого адреса тоже неправильно.
Если пользователь открывает:
/catalog/nonexistent-product/
сервер не должен выдавать успешный ответ с пустой страницей или сообщением «Товар не найден».
Для действительно отсутствующего документа следует возвращать 404 или 410. Если товар перенесён на новый адрес, используется соответствующий редирект.
В чистых CSR-приложениях, где сервер не может определить существование маршрута, возможна обработка ошибочного состояния с добавлением noindex, но это обходной вариант. Для публичных страниц корректные серверные статусы предпочтительнее.
Ошибка №6. Контент скрыт за интерактивной загрузкой
JavaScript позволяет загружать элементы по мере прокрутки или после нажатия кнопки.
Это нормально для пользовательского интерфейса, но может осложнять обнаружение дополнительных страниц.
Например, каталог показывает первые 20 товаров, а остальные доступны исключительно через кнопку «Показать ещё».
Если новые товары появляются только после нажатия, поисковая система может не обнаружить ссылки на них.
Что делать
Для больших каталогов и архивов стоит предусмотреть обычную пагинацию:
/catalog/drills/
/catalog/drills/?page=2
/catalog/drills/?page=3
Каждая страница должна иметь доступный URL и ссылки на соответствующие следующие или предыдущие части списка.
Интерфейс при этом может использовать бесконечную прокрутку. Главное, чтобы обнаружение контента не зависело исключительно от пользовательских действий.
Аналогичный принцип применяется к архивам статей и другим большим спискам.
Ошибка №7. JavaScript-файлы или API недоступны роботу
Иногда проблема находится за пределами HTML.
Например:
/assets/app.js       → 403
/assets/vendor.js    → 404
/api/products/123    → 500
В браузере разработчика сайт может открываться нормально, а поисковый робот сталкивается с ограничениями CDN, WAF или нестабильным API.
Последствия зависят от назначения ресурса. Если не загружается второстепенный аналитический скрипт, основной контент может остаться доступным. Если ошибка возникает в приложении, которое формирует карточки товаров, страница может оказаться пустой.
При диагностике необходимо проверить HTTP-ответы критических ресурсов, правила доступа, серверные ошибки и работу приложения без пользовательской авторизации.
Дополнительно стоит учитывать кэширование: при выпуске новой версии JavaScript полезно использовать имена файлов с хешем содержимого, чтобы поисковые роботы не получали устаревшие бандлы.
Ошибка №8. Гидратация изменяет содержимое страницы
На SSR-сайтах первоначальный HTML может быть полностью корректным. Проблемы начинаются после запуска клиентского приложения.
Этот процесс называется гидратацией — JavaScript подключает интерактивную логику к HTML, сформированному сервером.
Если серверное и клиентское состояния расходятся, возможны:
- исчезновение части текста;
- замена содержимого;
- неправильные заголовки;
- удаление ссылок;
- ошибки интерфейса.
Например, сервер передал полноценную карточку товара, но клиентский запрос к API завершился ошибкой и заменил описание пустым блоком.
Поэтому на SSR-проектах важно проверять не только исходный HTML, но и состояние страницы после гидратации.
Ошибка №9. Structured data не соответствует содержимому
JavaScript позволяет динамически добавлять JSON-LD, и Google способен обрабатывать такую разметку.
Но если она формируется через нестабильный API или содержит данные от другого маршрута, возникают проблемы.
Например, карточка одного товара может получить Schema.org от ранее открытой модели.
Для интернет-магазина это особенно критично, когда речь идёт о названии, цене, наличии и идентификаторах товара.
Разметка должна соответствовать текущему URL и информации, которую видит пользователь.
Для SSR- и SSG-проектов практично формировать JSON-LD вместе с HTML. При клиентской генерации необходимо отдельно тестировать итоговое содержимое.
Ошибка №10. Избыточный JavaScript замедляет сайт
Даже правильно индексируемое приложение может работать медленно из-за большого объёма клиентского кода.
Причины часто связаны с тяжёлыми библиотеками, длительными задачами в основном потоке, неэффективной обработкой событий и сторонними скриптами.
Особенно заметны проблемы на мобильных устройствах.
Для диагностики используют Core Web Vitals:
| Показатель | Что измеряет |
| LCP | Скорость отображения основного контента |
| INP | Отзывчивость интерфейса |
| CLS | Стабильность расположения элементов |
Оптимизация может включать разделение JavaScript-бандлов, удаление ненужных зависимостей, сокращение клиентской работы и уменьшение количества тяжёлых операций.
При этом переход на SSR сам по себе не гарантирует высокую скорость. Плохо настроенный серверный рендеринг тоже способен ухудшать производительность.
Dynamic Rendering: стоит ли использовать
Dynamic Rendering — подход, при котором пользователю отдаётся обычная JavaScript-версия, а отдельным поисковым роботам — предварительно обработанная HTML-страница.
Раньше он применялся для обхода ограничений некоторых краулеров.
Сегодня Google рассматривает такой метод как временное решение, а не предпочтительную архитектуру нового проекта.
Причина в дополнительной сложности: приходится поддерживать два способа формирования страниц и следить, чтобы их содержимое не расходилось.
Для новых сайтов обычно рациональнее использовать SSR, SSG или гибридную архитектуру.
Как провести JavaScript SEO-аудит
Не стоит проверять только главную страницу. Ошибки чаще обнаруживаются на отдельных шаблонах.
Для интернет-магазина можно взять главную, категорию, карточку товара, статью, пагинацию и несуществующий URL.
- Проверьте ответ сервера
Убедитесь, что существующие страницы возвращают корректный статус, а удалённые — соответствующую ошибку или перенаправление.
- Изучите исходный HTML
Проверьте наличие основного текста, H1, метаданных, canonical, robots и ссылок.
- Сравните результат рендеринга
В браузере посмотрите итоговый DOM после выполнения JavaScript и убедитесь, что важная информация не исчезает.
- Проверьте URL через Search Console
Инструмент проверки URL позволяет изучить полученную Google страницу, доступность ресурсов и результат рендеринга.
- Проверьте навигацию
Категории, карточки и страницы пагинации должны иметь обычные ссылки с корректными адресами.
- Изучите ошибки JavaScript
Проверьте консоль браузера, сетевые запросы и критические API.
- Сравните разные шаблоны
У категорий, товаров и статей должны быть собственные метаданные, корректные canonical и соответствующее содержимое.
- Повторите проверки после обновления
Изменения в системе маршрутизации, серверном рендеринге или гидратации способны повлиять на SEO даже тогда, когда разработчики не меняли метаданные напрямую.
Почему не индексируются карточки товаров
Предположим, интернет-магазин разработан как SPA.
После запуска обнаруживаются следующие проблемы:
- у всех товаров одинаковый Title;
- часть карточек отдаёт 404 при прямом обращении;
- описание появляется только после запроса к API;
- товары со второй страницы каталога доступны исключительно через кнопку;
- некоторые JavaScript-файлы блокируются системой защиты.
В такой ситуации переписывание текстов не решит проблему.
Работу следует начать с технической архитектуры.
Сначала необходимо настроить корректную обработку URL и HTTP-статусов. Затем обеспечить стабильную доступность товарного контента, исправить метаданные и навигацию. После этого — повторно проверить страницы через Search Console.
Только после устранения ошибок можно объективно оценивать, как изменились индексация, показы и органический трафик.
Чек-лист перед запуском JavaScript-сайта
| Проверка | Что должно работать |
| Основной контент | Доступен в HTML или корректно отображается после рендеринга |
| Title и Description | Соответствуют конкретному URL |
| Canonical | Не содержит противоречивых значений |
| Robots | Нет случайного noindex |
| Внутренние ссылки | Используют корректный href |
| SPA-маршруты | Открываются напрямую |
| Несуществующие URL | Корректно обрабатываются |
| Пагинация | Имеет доступные URL и ссылки |
| JavaScript и API | Не содержат критических ошибок |
| Гидратация | Не удаляет важный контент |
| Structured data | Соответствует текущей странице |
| Производительность | Нет критических проблем с LCP, INP и CLS |
Этот чек-лист стоит включить в регрессионные проверки перед публикацией крупных обновлений.
JavaScript не является препятствием для поискового продвижения. Проблемы появляются тогда, когда архитектура сайта делает основной контент, навигацию или метаданные зависимыми от нестабильного клиентского выполнения кода.
Для публичных страниц особенно важны корректные HTTP-ответы, доступный HTML, работающие внутренние ссылки и согласованность данных до и после рендеринга.
При этом не существует требования переводить весь сайт на SSR. Для многих проектов оптимальным решением становится сочетание серверного или статического рендеринга с клиентскими интерактивными функциями.
Проверять JavaScript SEO следует не по внешнему виду страницы в браузере, а по всей цепочке обработки: ответ сервера → первоначальный HTML → выполнение JavaScript → итоговое содержимое → индексация.
Такой подход позволяет находить реальные технические причины проблем и устранять их без ненужной переработки всего проекта.